超导路线
IBM推出520比特Nighthawk r3芯片并公布千比特互联路线图
继近几期报道IBM超导硬件演进后,北京时间2026年11月12日,IBM在量子开发者大会上正式发布Nighthawk r3超导处理器,单芯片集成520个可编程量子比特,并发布了面向2027年实现1,040量子比特的多芯片互联技术路线图,同时上线了托管式混合工作流系统[8]。对照当前超导生产系统基线,头部芯片(如Heron r2及Willow的105至120比特)普遍追求99.5%至99.9%的双比特门保真度(双量子位操作准确率),Nighthawk r3将单芯片可编程规模从前代Nighthawk的120比特拉升至520比特,增幅达3.33倍[8];但高密度超导阵列仍受制于TLS(两能级系统缺陷态)波动与微波串扰,距离Google Willow实现的表面码(二维拓扑容错纠错码)容错阈值(误差压制因子Λ≈2.1)仍有待独立第三方给出全分布保真度与实时纠错闭环数据。该芯片将直接强化IBM云端全栈算力矩阵,加剧与主打高保真小芯片路线厂商的生态分化,企业级客户预计将在2027年前验证其在中等深度电路上的协同加速价值。
Q-CTRL展示21比特超导芯片三小时内自主冷启动校准
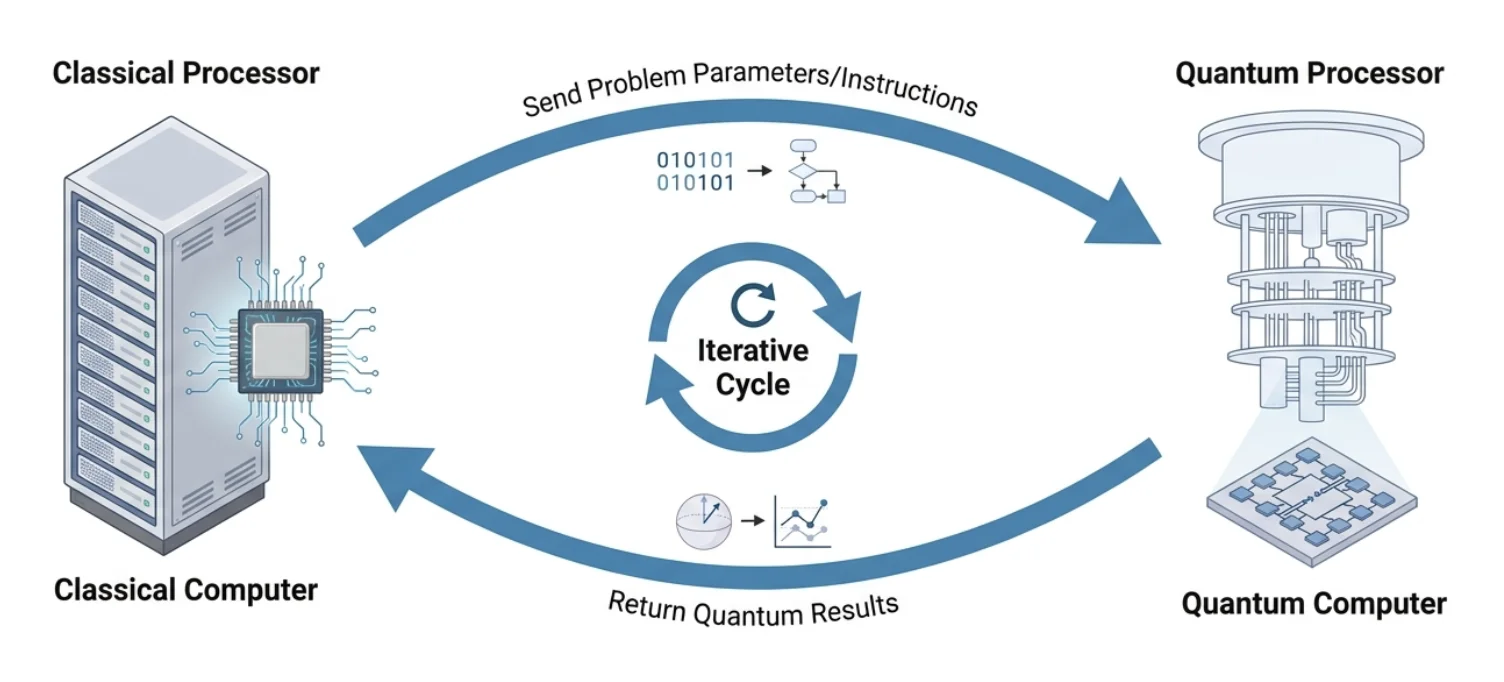
Q-CTRL利用其Boulder Opal控制平台,在荷兰芯片厂商QuantWare的21比特Contralto-D21超导处理器上完成了全流程一键式冷启动校准,将整机从无参数初始态推进到具备可用门保真度状态的耗时缩减至3小时以内[10]。相比以往高度依赖资深工程师手动调试脉冲、通常耗时48至72小时的繁琐工程,该技术将超导处理器的停机校准维护耗时缩短90%以上,跨越了规模化量子硬件常态化部署的人力瓶颈[10]。这将直接利好第三方开放式芯片制造商与无独立控制算法团队的科研机构,推动超导算力向数据中心标准化机架式设备过渡,预计2年内将成为模块化超算中心采购的基本配置要求。
英伟达携手Alice & Bob以高速总线直连GPU解码猫量子比特
法国初创公司Alice & Bob联合英伟达,利用NVQLink(量超协同高速互联总线)技术将GPU算力单元与受拓扑保护的猫量子比特(相干态叠加玻色比特)系统打通,实测完成了LDPC(低密度奇偶校验码)纠错解码流程[16]。对照硬件纠错开销基线,主流二维表面码需要大约105:1的物理/逻辑比特开销(如Google表面码体系),而猫量子比特利用相干态物理对称性自主抑制比特翻转错误,结合LDPC码有望将物理/逻辑比特比例压缩至10:1以下;本次借助经典微架构在微秒级时间内完成伴随式解码,攻克了玻色纠错实时综合反馈的延迟壁垒[16]。此举巩固了经典芯片巨头在量子容错底层算力中的生态卡位,使拓扑玻色路线的商业工程化验证周期预期缩短2至3年。
Rigetti第三季度营收140万美元并锁定联邦1亿美元潜在协议
继近几期报道其被动式降本与技术路线演进后,Rigetti公布2026年第三季度财报,当季实现营收140万美元,净亏损控制在310万美元,同时锁定来自美国商务部潜在总额达1亿美元的采购协议[15]。净亏损较此前高位明显收窄,联邦采购意向为其推进84比特和108比特Cepheus-1芯片的晶圆级模块化拼接提供了流动性托底[15]。这为纯超导全栈硬件上市企业注入了抗周期资金,为其在2027年前将双比特门保真度推升至99.5%以上中位线并验证多芯片低温互联赢得了约两年的窗口期。
中性原子路线
Quantum X Labs公布2030年实现800个逻辑比特执行路线图
中性原子研发企业Quantum X Labs发布最新技术规划,设定在2030年前通过操控逾10万个物理量子比特,构建出约800个容错逻辑量子比特系统[21]。对照中性原子领域公开SOTA基线,目前全球最高已验证逻辑比特数为QuEra在Nature 2026报道的96个逻辑比特(基于448个物理比特与[[16,6,4]]码),而最大物理阵列纪录为Atom Computing的1,180比特;该规划宣称的目标将物理比特规模扩大约85倍、逻辑比特提升逾8倍,属于厂商远期规划承诺,依然面临中性原子系统重复率仅1至10赫兹的刚性物理约束以及原子连续装载补充时的损耗瓶颈。该路线图加剧了中性原子阵列规模扩张赛道的融资竞争,但投资界与防务评估机构将重点核验其逻辑操作全流程中是否存在未公开的后选择率筛选。
共振荧光直读技术攻克冷原子探测相机时延瓶颈
科研人员在中性原子体系中成功验证了基于共振荧光的快速量子态无损探测方案,绕开了传统电子倍增电荷耦合器件相机的曝光与帧传输延迟[25]。传统相机探测引入的耗时通常在10至50毫秒区间,而共振荧光直读技术将原子量子比特的状态测量时间压缩至亚毫秒级(缩短一个数量级以上),跨越了计算过程中单比特测量与重置用于实时量子纠错的关键时延门槛[25];但在密集原子阵列中,该方案仍需补齐抑制自发辐射杂散光对相邻数据比特退相干干扰的微区空间光隔离指标。这为基于光镊穿梭阵列的在线实时反馈纠错扫清了物理时延障碍,有助于中性原子硬件在纠错循环时钟周期上缩小与超导路线的天然差距。
离子阱与光子路线
电光转换器在光波与毫米波波段创下67%能量转换效率
科研团队研制出一种新型三共振电光转换器件,成功在光纤通信光波与微波毫米波之间实现了高达67%的量子态信号能量转换效率[24]。对照跨频段量子互联基线,此前微波到光波的转换效率长期徘徊在10%至30%之间,67%的指标相当于此前主流报道水平的2.2倍以上,刷新了公开报道的历史极值,为连接不同制冷机内的量子芯片提供了高效率光电桥梁[24];不过器件距离分布式网络实用化仍缺关键项,即在毫开尔文低温环境下将光泵浦引入的热噪声光子数压低至量子基态极限(添加噪声光子数远低于1)。该进展将直接赋能超导与半导体量子点系统的分布式互联,为跨低温机柜组建模块化量子计算集群削减了3至5年的硬件研发周期。
单步动态去耦使量子三能级相干时间提高10倍以上
实验团队在超冷原子系综中利用简化的单步控制方案实现了保真度达93%的量子三能级(含三个基态的量子单元)高维逻辑门,并使量子相干时间延长了10倍以上(超过一个数量级),同步演示了三通道马赫-曾德尔干涉仪[18]。该方案消除了传统多脉冲序列累积带来的退相位误差,以紧凑的单脉冲动力学去耦证明了高能级量子态在长相干操控中的工程可行性[18];然而对照主流两比特门保真度99.9%以上的SOTA水平,93%的门精度距离高维容错纠错门槛仍差至少一个数量级的精度。该成果将主要利好高灵敏度量子重力测量仪与紧凑型量子频标设备,为国防地质勘探与惯性制导系统的小型化开辟了新物理通道。
DARPA推进QBI计划至C阶段严格核算算力投入产出比
美国国防高级研究计划局(DARPA)量子基准倡议(QBI)进入C阶段验证,IonQ联邦首席科学家受访披露该阶段聚焦系统算力价值是否实质性超越硬件全生命周期成本的底线核算[2]。这意味着国家级科研采购对离子阱及其他全栈路线的评估由单一实验室物理参数(如门保真度或量子比特数)转向全系统计算收益与总拥有成本的经济学评价[2]。这将倒逼离子阱阵列加快攻克离子穿梭运输耗时过长与多路激光调制器集成度不足的瓶颈,决定未来数年内百亿美元规模政府与防务长期订单的流向。
自旋量子点路线
代尔夫特自旋量子点团队斩获欧洲研究理事会协同基金
北京时间2026年11月12日,来自荷兰代尔夫特理工大学和QuTech的四位核心物理学家联合获得欧洲研究理事会(ERC)协同基金资助,专项攻坚硅基自旋量子比特的扩展化网络与保真度极限[19]。目前硅基自旋双比特门保真度最高达99.99%(单对施主原子),且已在300毫米晶圆上实现随机抽测大于99%,但受制于微观电荷噪声波动,多比特扩展器件普遍停留在10比特左右;该联合基金旨在攻克密集纳米栅极扇出布线与片上微波控制的工程死结[19]。此项长期资本注入将巩固欧洲在硅基CMOS(互补金属氧化物半导体)兼容制造路线上的领先地位,加快半导体代工厂利用现有极紫外光刻产线导入量子芯片流片的进程。